OpenStack trên Kubernetes với Genestack – Phần 9: Thay thế một controller node
Thêm compute node (Phần 8) là thao tác “chỉ có thêm”. Thay một controller thì khác hẳn: trên controller có những cụm vận hành theo quorum, và một bước sai có thể làm cả cloud ngừng hoạt động. Mỗi controller trong Genestack đang giữ:
| Thành phần | Dạng | Định danh theo |
|---|---|---|
| etcd | Raft, chạy systemd trên host | IP của node |
| Kubernetes control plane | Static pod | Tên và IP của node |
OVN NB/SB (ovn-central) | Raft, pod của kube-ovn | IP của node (NODE_IPS) |
| MariaDB Galera, RabbitMQ | 3 pod, anti-affinity | Tên pod; dữ liệu nằm trên PVC Longhorn |
| Longhorn | Replica trên đĩa của node | Node Longhorn |
| cinder-volume (LVM) | systemd, volume nằm trên đĩa của node | <node>@lvm-ssd-1 |
| VIP của MetalLB | Speaker được bầu làm chủ | Node có label worker |
Bài này thay một controller cũ bằng openstack-controller-4, máy mới với IP hoàn toàn khác. Nguyên tắc xuyên suốt: thêm trước, bớt sau, và mỗi lần chỉ thay đổi một cụm.
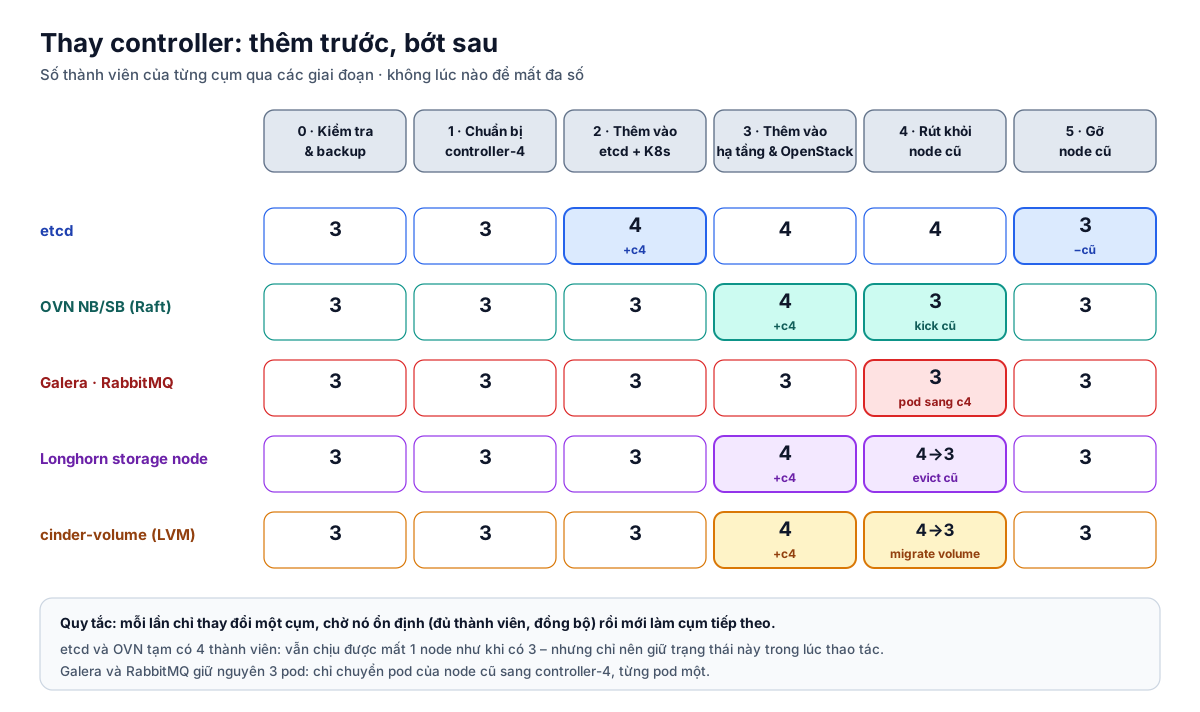
Trong lab, openstack-controller-2 là node cần thay, và openstack-controller-4 là máy thay thế:
| Node cũ | Node mới | |
|---|---|---|
| Tên | openstack-controller-2 | openstack-controller-4 |
br-host (enp3s0) | 10.0.0.110 | 10.0.0.191 |
br-overlay (enp10s0) | 192.168.1.100 | 192.168.1.12 |
Vị trí trong kube_control_plane | Thứ hai, không phải node đầu tiên | Thêm vào cuối |
| Pod có state đang chạy (lúc viết) | mariadb-cluster-1 (primary), rabbitmq-server-1, memcached-0 | – |
1
2
3
OLD=openstack-controller-2   OLD_IP=10.0.0.110
NEW=openstack-controller-4   NEW_IP=10.0.0.191
os() { kubectl -n openstack exec -i openstack-admin-client -- openstack "$@"; }
Nếu node cũ là node đầu tiên của nhóm
kube_control_planetrong inventory (trong lab là controller-1), có thêm vài bước riêng. Xem mục “Trường hợp node đầu tiên” ở cuối bài.
Giai đoạn 0 – Kiểm tra sức khoẻ và backup
Chỉ bắt đầu khi cluster hoàn toàn khoẻ. Nếu etcd đang chậm, hoặc Galera, RabbitMQ vừa bị chia mạng, thay controller sẽ biến một sự cố nhỏ thành sự cố lớn.
etcd do Kubespray cài chạy với TLS. Các lệnh etcdctl trong bài chạy trên một controller, qua hàm tiện ích sau. Kubespray đặt chứng chỉ admin của từng node theo tên host:
1
2
3
4
5
6
ectl() {
  etcdctl --endpoints=https://127.0.0.1:2379 \
    --cacert=/etc/ssl/etcd/ssl/ca.pem \
    --cert=/etc/ssl/etcd/ssl/admin-$(hostname).pem \
    --key=/etc/ssl/etcd/ssl/admin-$(hostname)-key.pem "$@"
}
1
2
3
4
5
6
7
kubectl get nodes
ectl endpoint status --cluster -w table                  # trên một controller: 3 member, có 1 leader
kubectl -n openstack get mariadb                         # READY=True
kubectl -n openstack exec rabbitmq-server-0 -- rabbitmqctl cluster_status   # Running Nodes đủ 3
kubectl ko nb status ; kubectl ko sb status              # 3 server, có leader
kubectl -n longhorn-system get volumes.longhorn.io       # mọi volume healthy
os compute service list ; os network agent list ; os volume service list
Ngoài trạng thái hiện tại, xem thêm số lần restart của kube-controller-manager và kube-scheduler, cùng log cảnh báo của etcd (apply request took too long). Nếu chúng tăng liên tục, control plane đang có vấn đề cần xử lý trước.
Backup trước khi thay đổi:
1
2
3
4
5
6
7
8
9
10
# etcd snapshot, chạy trên một controller (cần hàm ectl ở trên)
ectl snapshot save /root/etcd-$(date +%F-%H%M).db
etcdutl snapshot status $(ls -t /root/etcd-*.db | head -1) -w table   # kiểm tra file (etcd 3.6: dùng etcdutl)
# MariaDB: dump toàn bộ (Phần 4b)
kubectl -n openstack exec mariadb-cluster-0 -c mariadb -- sh -c \
  'mariadb-dump -uroot -p"$MARIADB_ROOT_PASSWORD" --all-databases --single-transaction' | gzip > /root/mariadb-$(date +%F).sql.gz
# OVN NB/SB
kubectl ko nb backup ; kubectl ko sb backup
# Cấu hình Genestack
tar czf /root/etc-genestack-$(date +%F).tgz /etc/genestack
Giai đoạn 1 – Chuẩn bị đĩa cho controller-4
Giả định controller-4 đã sẵn sàng giống các node khác như ở Phần 8: port trên cloud đã cấu hình, tên NIC giống các node cũ, đặt hostname, và deployer SSH được vào bằng root. Việc còn lại là chuẩn bị đĩa.
Controller-4 được gắn hai volume:
| Thiết bị | Dung lượng | Dùng cho |
|---|---|---|
/dev/vdd | 50 GB | Longhorn (mount tại /var/lib/longhorn-disk2) |
/dev/vde | 100 GB | Cinder LVM (volume group cinder-volumes) |
Chạy trên controller-4:
1
2
3
4
5
6
7
8
9
10
11
lsblk        # xác nhận vdd và vde còn trống, chưa có filesystem

# Longhorn
mkfs.ext4 -L longhorn-disk2 /dev/vdd
mkdir -p /var/lib/longhorn-disk2
echo "UUID=$(blkid -s UUID -o value /dev/vdd) /var/lib/longhorn-disk2 ext4 defaults,nofail 0 2" >> /etc/fstab
mount /var/lib/longhorn-disk2

# Cinder LVM
pvcreate --metadatasize 2048 /dev/vde
vgcreate cinder-volumes /dev/vde
Kiểm tra:
1
2
df -h / /var/lib/longhorn-disk2
vgs cinder-volumes
Ổ root cũng cần đủ chỗ: etcd, containerd và hàng chục image OpenStack đều nằm trên đó. Hãy để ổ root không nhỏ hơn các controller hiện có (lab: 160 GB). Nếu máy boot từ volume, kiểm tra kích thước volume boot chứ đừng chỉ nhìn flavor.
Giai đoạn 2 – Thêm vào etcd và control plane
Inventory
Thêm openstack-controller-4 vào all.hosts và vào các nhóm kube_control_plane, etcd, kube_node, openstack_control_plane, ovn_network_nodes, cinder_storage_nodes. Với kube_control_plane và etcd, luôn thêm vào cuối danh sách. Kubespray không hỗ trợ thêm node control plane ở vị trí đầu.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
all:
  hosts:
    # …
    openstack-controller-4:
      ansible_host: 10.0.0.191
      ip: 10.0.0.191
      access_ip: 10.0.0.191
  children:
    k8s_cluster:
      children:
        kube_control_plane:
          hosts:
            openstack-controller-1: null
            openstack-controller-2: null
            openstack-controller-3: null
            openstack-controller-4: null      # cuối danh sách
        etcd:
          hosts:
            openstack-controller-1: null
            openstack-controller-2: null
            openstack-controller-3: null
            openstack-controller-4: null      # cuối danh sách
        # kube_node, openstack_control_plane, ovn_network_nodes, cinder_storage_nodes: thêm tương tự
Controller-2 vẫn ở trong inventory cho tới giai đoạn 5.
Chạy Kubespray
1
2
3
4
5
6
7
8
source /opt/genestack/scripts/genestack.rc
cd /opt/genestack/ansible/playbooks && ansible-playbook host-setup.yml --limit $NEW

cd /opt/genestack/submodules/kubespray
ansible-playbook playbooks/facts.yml --become -e ignore_assert_errors=yes
ansible-playbook cluster.yml --become --limit=etcd,kube_control_plane -e ignore_assert_errors=yes
ansible-playbook upgrade-cluster.yml --become --limit=etcd,kube_control_plane \
  -e ignore_assert_errors=yes -e '{"drain_nodes": false}'
- Không cần
-i:genestack.rcđã đặtANSIBLE_INVENTORY=/etc/genestack/inventory, nên mọi lệnhansiblevàansible-playbooktrong cùng phiên đều tự dùng inventory của Genestack. Mở terminal mới thì nhớsourcelại. -e ignore_assert_errors=yescho mọi playbook Kubespray khi inventory có 4 node etcd, kể cảfacts.yml. Kubespray kiểm tra số node etcd phải là số lẻ (taskvalidate_inventory : Stop if even number of etcd hosts). Thiếu biến này, playbook dừng ngay vớiAssertion failed. Điều này đúng cho tới khi gỡ xong node cũ ở giai đoạn 5.- Phải dùng
cluster.yml, không dùngscale.yml, khi thêm control plane. - Cần chạy
upgrade-cluster.ymlđể mọi node cập nhật cấu hình etcd mới. - Không drain khi chạy
upgrade-cluster.yml. Mặc định playbook này cordon và drain lần lượt từng control plane. Ở Genestack, control plane cũng chạy Galera, RabbitMQ và Longhorn, nên drain sẽ đẩy podmariadb-cluster-*vàrabbitmq-server-*sang trạng tháiPending, vì anti-affinity không còn node trống. Đồng thời PDBinstance-manager-*của Longhorn chặn drain, khiến playbook treo ởDrain noderồi fail. Ở đây chỉ cần cập nhật manifest của kube-apiserver, không nâng phiên bản, nên không cần drain. Phải truyền dạng JSON-e '{"drain_nodes": false}': viết-e drain_nodes=falsethì Ansible nhận chuỗi"false", mà chuỗi khác rỗng luôn là true trongwhen:, nên playbook vẫn drain. - Lúc này etcd có 4 thành viên. Số chẵn vẫn chịu được mất một node, nhưng chỉ nên giữ trạng thái này trong lúc thao tác.
Restart nginx-proxy trên các node không phải control plane, để nạp danh sách API server mới. Kubespray cập nhật file cấu hình, nhưng proxy cần restart mới đọc lại:
1
2
ansible kube_node -b -m shell -a \
  "crictl ps --name nginx-proxy -q | xargs -r crictl stop"
Kiểm tra:
1
2
3
4
kubectl get node $NEW                       # Ready, ROLES control-plane
ectl member list -w table                   # trên một controller: 4 member
# Trên mỗi controller: --etcd-servers có đủ 4 IP
grep -o "etcd-servers=[^ ]*" /etc/kubernetes/manifests/kube-apiserver.yaml
Giai đoạn 3 – Thêm vào hạ tầng và OpenStack
Mỗi bước dưới đây đưa controller-4 vào một cụm. Kiểm tra xong bước này mới sang bước kế tiếp.
3a – Label vai trò và Longhorn
1
2
kubectl label node $NEW node-role.kubernetes.io/worker=worker openstack-control-plane=enabled \
  openstack-storage-node=enabled longhorn.io/storage-node=enabled ovn.kubernetes.io/ovs_dp_type=kernel
Chờ longhorn-manager chạy trên node mới, rồi khai báo ổ riêng cho Longhorn:
1
2
3
kubectl -n longhorn-system patch nodes.longhorn.io $NEW --type merge -p \
  '{"spec":{"disks":{"disk2":{"path":"/var/lib/longhorn-disk2","allowScheduling":true,"storageReserved":5368709120}}}}'
kubectl -n longhorn-system get nodes.longhorn.io      # $NEW Ready, Schedulable
Label worker cũng cho phép speaker MetalLB trên node mới giữ VIP.
3b – OVN central: thêm thành viên Raft
install-kube-ovn.sh lấy danh sách IP cho ovn-central từ các node có label kube-ovn/role=master:
1
2
3
4
kubectl label node $NEW kube-ovn/role=master
/opt/genestack/bin/install-kube-ovn.sh
kubectl -n kube-system get deploy ovn-central         # 4/4
kubectl ko nb status ; kubectl ko sb status           # 4 server, có NEW_IP
Thay đổi NODE_IPS sẽ rolling restart các pod ovn-central. Chờ NB và SB có đủ 4 thành viên rồi mới tiếp tục.
3c – OVN cho Neutron: annotate trước, label sau
Như Phần 8: DaemonSet ovn-setup chỉ đọc annotation một lần, nên phải annotate trước khi gắn label openstack-network-node:
1
2
3
4
5
6
7
for a in int_bridge=br-int bridges=br-ex ports=br-ex:enp11s0 mappings=physnet1:br-ex \
         availability_zones=az1 gateway=enabled; do
  kubectl annotate node $NEW ovn.openstack.org/$a
done
kubectl label node $NEW openstack-network-node=enabled
kubectl get node $NEW -L ovn.openstack.org/configured
os network agent list --host $NEW                     # Gateway agent + Metadata agent
3d – cinder-volume trên node mới
1
2
3
ansible-playbook /opt/genestack/ansible/playbooks/deploy-cinder-volume.yaml --limit $NEW \
  -e cinder_backend_name=lvm-ssd-1 -e cinder_worker_name=lvm -e cinder_release_branch=stable/2025.1
os volume service list                                # $NEW@lvm-ssd-1 up
Giai đoạn 4 – Rút dần khỏi node cũ
4a – Cinder: chuyển volume khỏi node cũ
Volume LVM nằm trên đĩa của node cũ và không có bản sao ở đâu khác. Phải chuyển chúng đi trước khi gỡ node.
1
2
3
4
5
6
7
8
9
10
11
# Không cho tạo volume mới trên backend cũ
os volume service set --disable $OLD@lvm-ssd-1 cinder-volume

# Liệt kê volume đang nằm trên node cũ
for id in $(os volume list --all-projects -f value -c ID); do
  os volume show $id -f value -c id -c status -c os-vol-host-attr:host | paste -sd' '
done | grep "$OLD@"

# Chuyển từng volume sang backend khác
os volume migrate --host $NEW@lvm-ssd-1#lvm-ssd <volume-id>
os volume show <volume-id> -c os-vol-mig-status-attr:migstat -c os-vol-host-attr:host
Volume available được copy sang backend mới. Volume in-use thì Cinder nhờ Nova hoán đổi disk của VM đang chạy (swap volume). Thao tác này nên làm trong cửa sổ bảo trì, và từng volume một. migstat đi từ migrating sang success, và host đổi sang $NEW@lvm-ssd-1#lvm-ssd.
4b – Longhorn: evict replica khỏi node cũ
1
2
3
4
5
6
kubectl -n longhorn-system patch nodes.longhorn.io $OLD --type merge \
  -p '{"spec":{"allowScheduling":false,"evictionRequested":true}}'

# Chờ tới khi không còn replica trên node cũ và mọi volume healthy
kubectl -n longhorn-system get replicas.longhorn.io -o custom-columns=N:.metadata.name,NODE:.spec.nodeID | grep $OLD
kubectl -n longhorn-system get volumes.longhorn.io
Bước này còn có tác dụng gỡ PDB của instance-manager trên node cũ. Nếu còn replica, PDB đó sẽ chặn kubectl drain ở bước 4d.
4c – OVN: loại node cũ khỏi Raft
Tìm Server ID của node cũ: đó là dòng có OLD_IP trong mục Servers của kubectl ko nb status (tương tự với sb). Ví dụ trong lab:
1
2
3
4
Servers:
    3c89 (3c89 at tcp:[10.0.0.243]:6643) (self)
    4dbd (4dbd at tcp:[10.0.0.110]:6643)        ← controller-2, cần kick
    c6e1 (c6e1 at tcp:[10.0.0.174]:6643)
Server ID của NB và SB khác nhau, nên phải tra riêng từng cái. Rồi:
1
2
3
4
5
kubectl ko nb kick <nb-server-id-của-OLD>
kubectl ko sb kick <sb-server-id-của-OLD>
kubectl label node $OLD kube-ovn/role-
/opt/genestack/bin/install-kube-ovn.sh                # NODE_IPS còn 3 IP, không còn OLD_IP
kubectl ko nb status ; kubectl ko sb status           # 3 server, có leader
4d – Chuyển pod có state, rồi drain
Cordon node cũ để không pod mới nào được đặt lên đó. Sau đó chuyển từng pod có state một, và chờ cụm của nó hồi phục:
1
2
3
4
5
6
7
8
9
10
11
12
kubectl cordon $OLD
kubectl get pods -n openstack -o wide --field-selector spec.nodeName=$OLD | grep -E "mariadb|rabbitmq|memcached"

# MariaDB: pod được tạo lại trên $NEW (anti-affinity), PVC Longhorn đi theo
kubectl -n openstack delete pod <mariadb-cluster-N trên OLD>
kubectl -n openstack get mariadb -w                   # chờ READY=True; kiểm tra wsrep 3/Primary/Synced

# RabbitMQ: tương tự, chờ cluster_status có đủ 3 Running Nodes
kubectl -n openstack delete pod <rabbitmq-server-N trên OLD>

# Phần còn lại
kubectl drain $OLD --ignore-daemonsets --delete-emptydir-data
Giai đoạn 5 – Gỡ node cũ
5a – Gỡ khỏi Kubernetes và etcd
Khi node cũ vẫn còn trong inventory, chạy:
1
2
3
source /opt/genestack/scripts/genestack.rc
cd /opt/genestack/submodules/kubespray
ansible-playbook remove-node.yml --become -e node=$OLD -e skip_confirmation=yes -e ignore_assert_errors=yes
Playbook drain node, loại nó khỏi etcd, xoá node khỏi Kubernetes và reset máy. Nếu node cũ đã chết hẳn, thêm -e reset_nodes=false -e allow_ungraceful_removal=true.
Sau đó xoá $OLD khỏi mọi nhóm trong inventory, rồi sinh lại cấu hình trên các node còn lại và restart nginx-proxy:
1
2
ansible-playbook cluster.yml --become
ansible kube_node -b -m shell -a "crictl ps --name nginx-proxy -q | xargs -r crictl stop"
Kiểm tra: etcd còn 3 member, --etcd-servers trên mọi controller không còn OLD_IP.
5b – Dọn dẹp phía hạ tầng và OpenStack
1
2
3
4
5
6
7
8
9
# Longhorn
kubectl -n longhorn-system delete nodes.longhorn.io $OLD

# Cinder: xoá service của node cũ khỏi database
kubectl -n openstack exec deploy/cinder-api -- cinder-manage service remove cinder-volume $OLD@lvm-ssd-1
kubectl -n openstack exec deploy/cinder-api -- cinder-manage service remove cinder-backup $OLD

# Neutron: xoá agent của node cũ
for a in $(os network agent list --host $OLD -f value -c ID); do os network agent delete $a; done
Nếu kubeconfig trên deployer đang trỏ tới OLD_IP, đổi trường server sang IP của một controller còn lại. Cuối cùng, tắt và xoá máy ảo cũ trên cloud.
Trường hợp node đầu tiên
Kubespray dùng node đầu tiên của kube_control_plane làm điểm tham chiếu (lab: openstack-controller-1, cũng là IP trong cluster-info và trong kubeconfig của deployer). Nếu cần thay node đầu tiên, trước giai đoạn 5:
- Đổi thứ tự trong inventory: đẩy node cũ xuống cuối các nhóm
kube_control_plane,etcd,kube_node. - Chạy
cluster.yml(hoặcupgrade-cluster.yml -e '{"drain_nodes": false}'). - Sau khi
remove-node.ymlxong, sửa ConfigMapcluster-infođể trườngservertrỏ tới một control plane còn sống:1
kubectl -n kube-public edit cm cluster-info - Sửa kubeconfig trên deployer theo cùng địa chỉ đó.
Checklist cuối cùng
| Cụm | Kiểm tra | Mong đợi |
|---|---|---|
| Kubernetes | kubectl get nodes | Không còn $OLD. $NEW Ready, control-plane |
| etcd | member list | 3 member, không có OLD_IP |
| OVN | kubectl ko nb status / sb status | 3 server, có NEW_IP |
| Galera | kubectl -n openstack get mariadb + wsrep | READY=True, 3/Primary/Synced |
| RabbitMQ | rabbitmqctl cluster_status | 3 Running Nodes |
| Longhorn | nodes.longhorn.io, volumes.longhorn.io | Không còn $OLD. Volume healthy |
| Cinder | os volume service list | Không còn $OLD@lvm-ssd-1. $NEW@lvm-ssd-1 up |
| Neutron | os network agent list | Không còn agent của $OLD |
| VIP | kubectl get servicel2statuses -A | VIP do một controller còn lại giữ |
Tóm tắt
- Controller giữ nhiều cụm có quorum: etcd, OVN Raft, Galera, RabbitMQ, cùng dữ liệu cục bộ của Longhorn và Cinder LVM.
- Chỉ bắt đầu khi cluster khoẻ, và backup etcd, MariaDB, OVN,
/etc/genestacktrước. - Thêm trước, bớt sau. Thêm controller-4 vào etcd và control plane (
cluster.yml+upgrade-cluster.yml), rồi lần lượt vào Longhorn, OVN, Neutron, Cinder. - Rút khỏi node cũ theo thứ tự: chuyển volume Cinder → evict Longhorn → kick khỏi OVN Raft → chuyển từng pod Galera/RabbitMQ → drain.
- Gỡ bằng
remove-node.yml, sửa inventory, chạy lạicluster.yml, restartnginx-proxy, dọn Longhorn, Cinder, Neutron. Node đầu tiên của control plane cần thêm bước đổi thứ tự và sửacluster-info.